AprilTag y ArUco markers: los marcadores fiduciales y su uso en la robótica
Cuando un robot percibe su entorno, muchas veces necesita saber dónde se encuentran los objetos y cuál es su posición respecto a ellos. Por ejemplo, para encontrar su estación de carga, localizar una pieza que debe tomar o identificar una zona de trabajo.
Una de las opciones más económicas para esto es utilizar una cámara 2D. Sin embargo, las imágenes nos proporcionan píxeles, no distancias ni posiciones en el espacio.
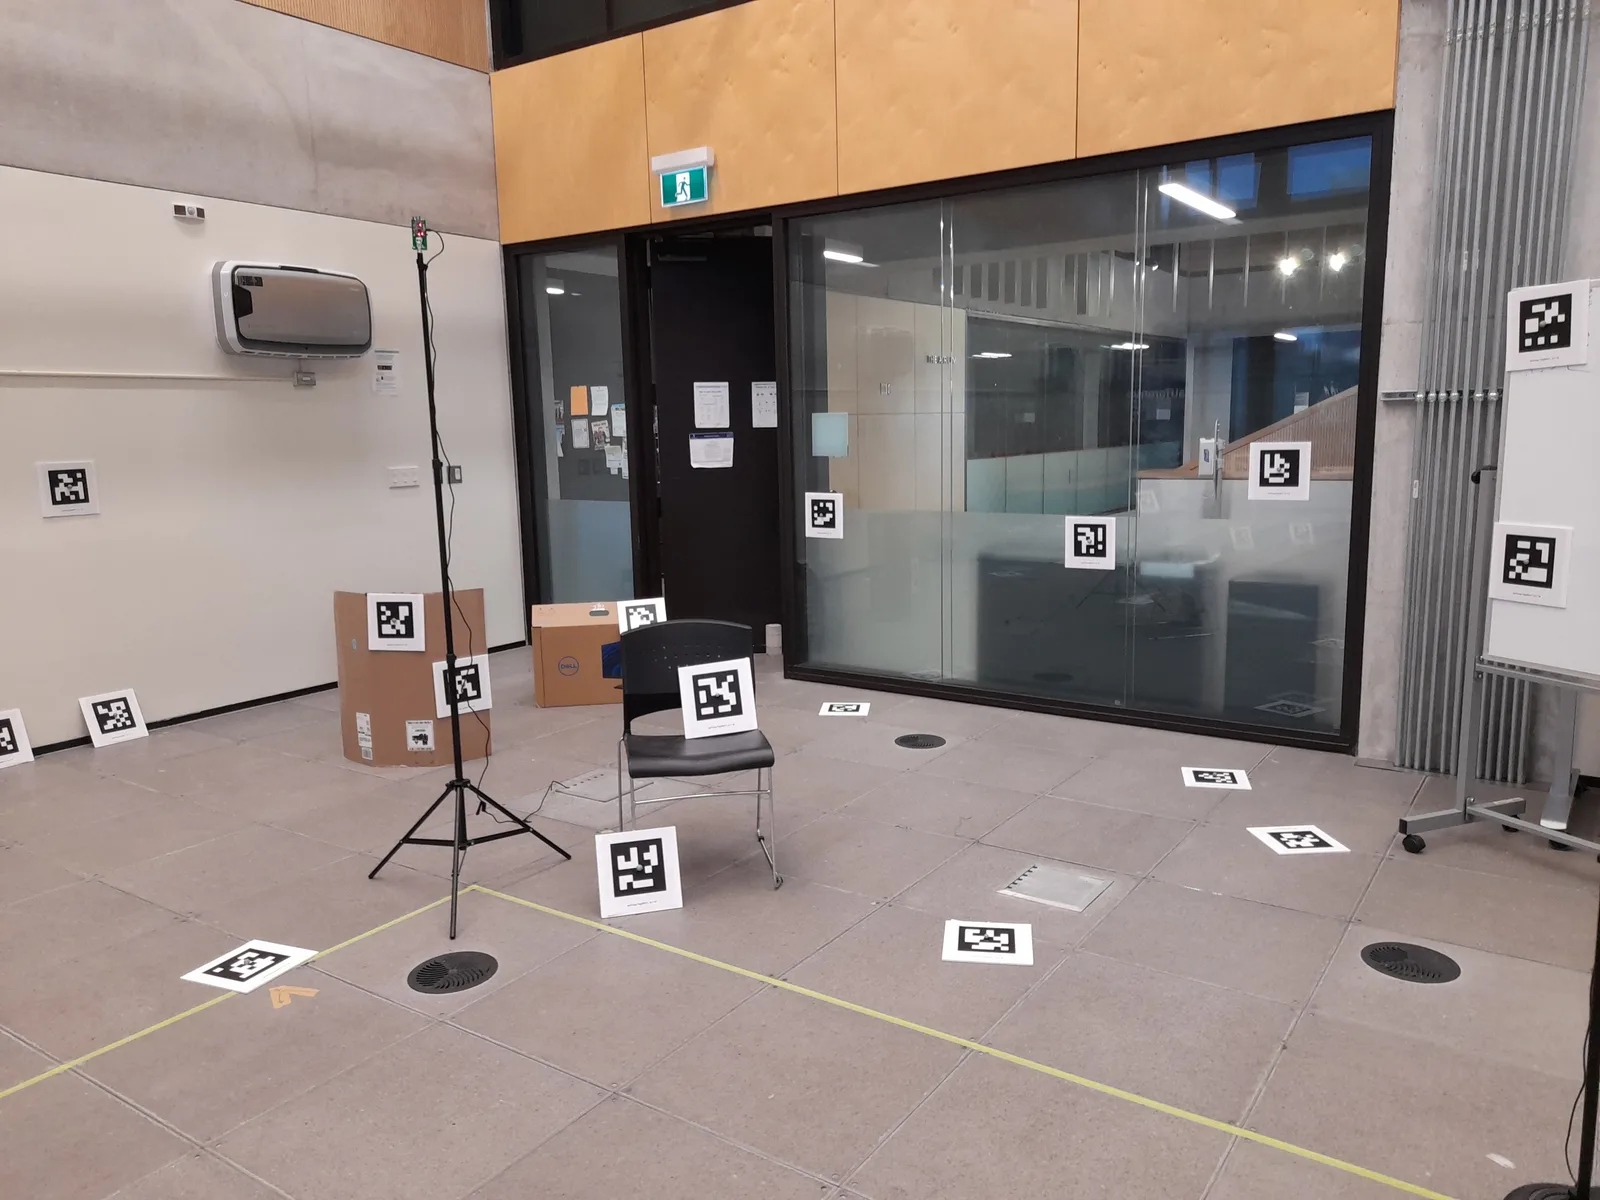 Un cuarto de laboratorio instrumentado con marcadores: cada uno es una referencia con identidad y posición conocidas. Foto: dataset STAR-loc, CC BY 4.0.
Una forma de resolverlo es utilizando marcadores fiduciales, imágenes similares a códigos QR con patrones diseñados para ser detectados por algoritmos de visión.
Al conocer el tamaño del marcador y utilizar una cámara calibrada, podemos estimar su posición (x, y, z) y orientación (roll, pitch, yaw) respecto a la cámara. Además, cada patrón contiene un ID que permite identificar el marcador y utilizarlo como punto de referencia.
Existen diferentes tipos de marcadores fiduciales, entre los que destacan AprilTag y ArUco, cada uno con distintas familias de patrones.
Qué es un marcador
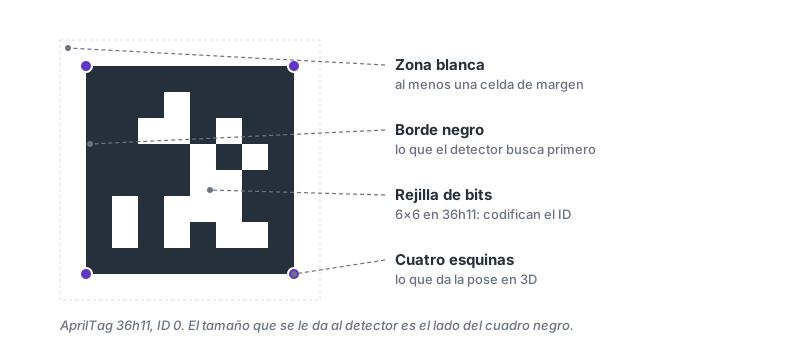
Un marcador fiducial se parece a un código QR, pero es mucho más simple. En lugar de guardar un texto, guarda un número pequeño que lo identifica, y está diseñado para detectarse de lejos y medirse con precisión, no para leerse de cerca.
Un marcador tiene tres partes, y cada una cumple una función:
- El borde negro. Es lo primero que busca el detector, porque se distingue de lejos y en ángulo, antes de que los bits se puedan leer.
- La rejilla de bits. Son las celdas blancas y negras del interior. Por ejemplo, en la familia 36h11 de AprilTag la rejilla es de 6 × 6 celdas, y su patrón codifica el ID del marcador.
- La zona blanca alrededor. Debe tener al menos el ancho de una celda. Sin ella, el borde negro se confunde con el fondo y el detector no lo encuentra.
Lo que realmente usamos para medir son las cuatro esquinas del borde. Con su posición en píxeles, el tamaño real del marcador y la calibración de la cámara, se puede calcular dónde está el marcador en el espacio. Por eso un marcador doblado, brillante o con una esquina tapada da una posición incorrecta o ninguna.
Los bits no son simplemente el ID escrito en binario, sino un código con corrección de errores. En la familia 36h11 hay 36 bits y dos IDs válidos difieren siempre en al menos 11 de ellos. Si la iluminación o el desenfoque cambian algunos bits, el detector puede corregirlos o descartar la lectura, pero no entrega un ID equivocado. Esto es lo que permite confiar en el marcador para mover un robot.
Los dos tipos más usados son AprilTag, desarrollado en la Universidad de Michigan y muy extendido en ROS 2, y ArUco, desarrollado en la Universidad de Córdoba e incluido en OpenCV. Ambos se detectan con el mismo tipo de algoritmo, y OpenCV puede leer los dos. También existe el tablero ChArUco, que no es un marcador sino un tablero de ajedrez con un ArUco en cada casilla blanca; es la opción habitual para calibrar cámaras.
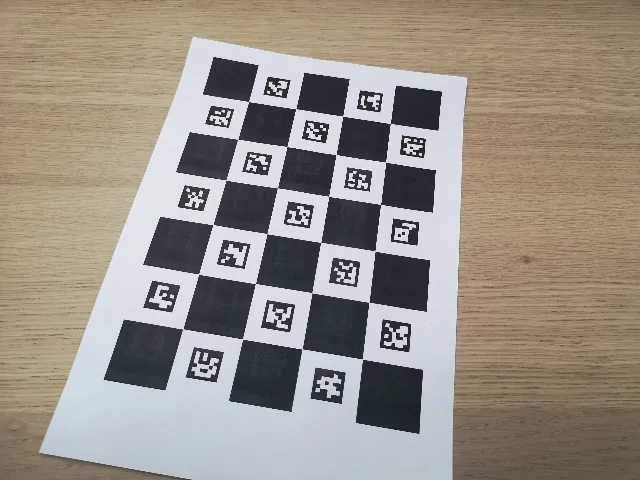 Un tablero ChArUco impreso: el ajedrez aporta las esquinas y los ArUco identifican cada una. Foto: OpenCV, Apache-2.0.
De píxeles a coordenadas 3D
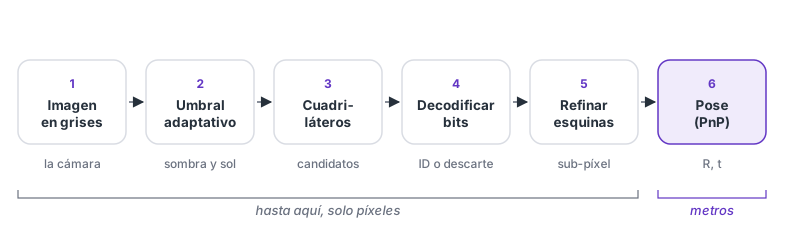
La detección usa técnicas clásicas de visión por computadora, sin redes neuronales, por lo que funciona en tiempo real en un procesador normal. El detector convierte la imagen a escala de grises, aplica un umbral adaptativo para separar lo claro de lo oscuro aunque la iluminación no sea uniforme, busca figuras de cuatro lados, rectifica el interior de cada una y lee sus bits. Si el resultado corresponde a un ID válido, refina la posición de las esquinas con una precisión menor a un píxel. Hasta aquí todo ocurre en la imagen: el detector entrega un ID y cuatro esquinas en píxeles.
Qué es una pose
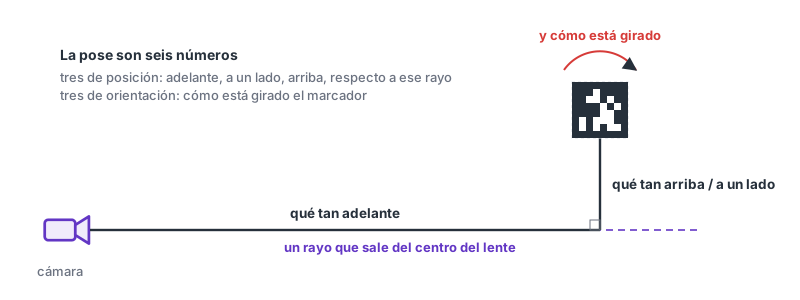
Imaginemos una línea que sale desde el centro del lente de la cámara. La pose del marcador son seis números medidos respecto a esa línea: qué tan adelante está, qué tan a un lado y qué tan arriba, además de cómo está girado en cada uno de los tres ejes. Con esta información el robot sabe a dónde dirigirse y con qué orientación llegar. Un marcador más cercano o más grande ocupa más píxeles, y por eso da una pose más precisa.
De las esquinas a la pose
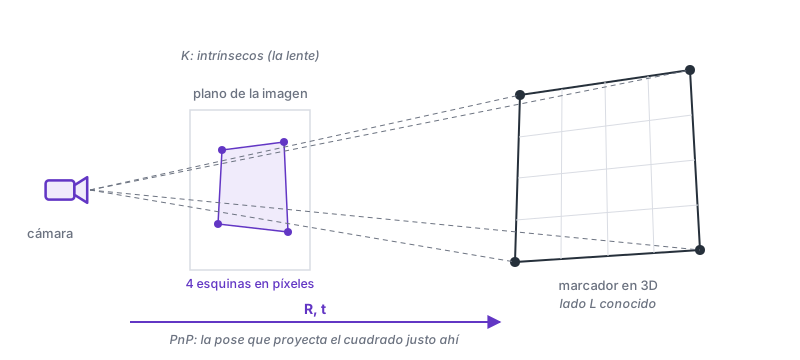
Una cámara calibrada proyecta cada punto del espacio a un píxel de la imagen según la ecuación
donde describe la lente (los parámetros intrínsecos) y y son la rotación y la traslación entre la cámara y el marcador, es decir, la pose. Las esquinas tienen coordenadas conocidas en el marcador, porque es un cuadrado de lado , y coordenadas medidas en la imagen. Encontrar y a partir de esas correspondencias es el problema conocido como PnP. Para un marcador cuadrado y plano se usa el método IPPE, disponible en OpenCV como SOLVEPNP_IPPE_SQUARE.
La ambigüedad del plano
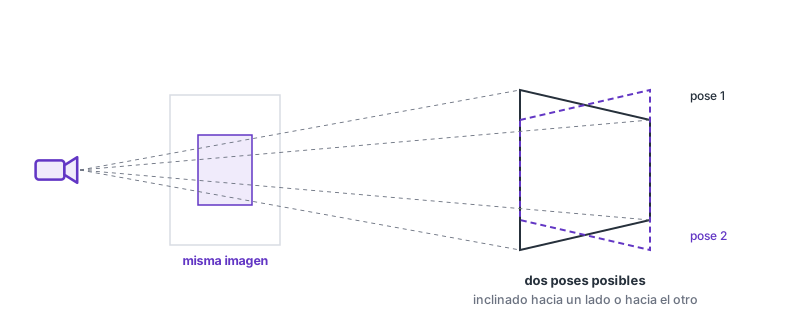
Cuando los cuatro puntos están en un mismo plano, dos poses distintas pueden producir casi la misma imagen. Un marcador inclinado hacia la izquierda y otro inclinado hacia la derecha se ven prácticamente iguales si están de frente y a media distancia. No es un error del algoritmo, sino una consecuencia de la geometría. IPPE devuelve las dos soluciones con su error de reproyección; cuando ambas se parecen, la orientación puede cambiar de una a otra entre un cuadro y el siguiente. La forma de evitarlo es colocar marcadores que no estén en el mismo plano, o apoyarse en otra fuente de información, como la odometría, un segundo marcador o una segunda cámara.
Precisión y calibración
La posición se estima bien a corta distancia y empeora conforme el marcador se aleja, porque ocupa menos píxeles. La orientación es lo más delicado: de frente, por la ambigüedad del plano, y muy inclinado, porque el ruido en las esquinas se convierte en grados de error. Además, nada de esto funciona sin calibrar la cámara. Sin los parámetros intrínsecos y la distorsión del lente, el detector encuentra las esquinas correctamente, pero las convierte a metros usando un modelo de lente que no corresponde al real. La calibración se hace una sola vez por cámara y resolución, con un tablero ChArUco y varias fotos desde distintos ángulos.
También hay situaciones en las que la detección falla o engaña: cuando hay movimiento y las esquinas salen borrosas, cuando un reflejo cae sobre una celda, cuando el marcador está doblado o sobre una superficie curva, cuando una esquina queda tapada, o cuando el tamaño declarado no coincide con el impreso. Por ejemplo, un marcador impreso al 97 % de su tamaño da distancias un 3 % más cortas, siempre y sin ningún aviso. Por eso, antes de permitir que una pose mueva un motor, conviene verificar que el error de reproyección sea bajo y estable, que la distancia y el ángulo estén dentro del rango esperado, que no haya saltos entre cuadros y que la pose esté expresada en el marco que el controlador espera.
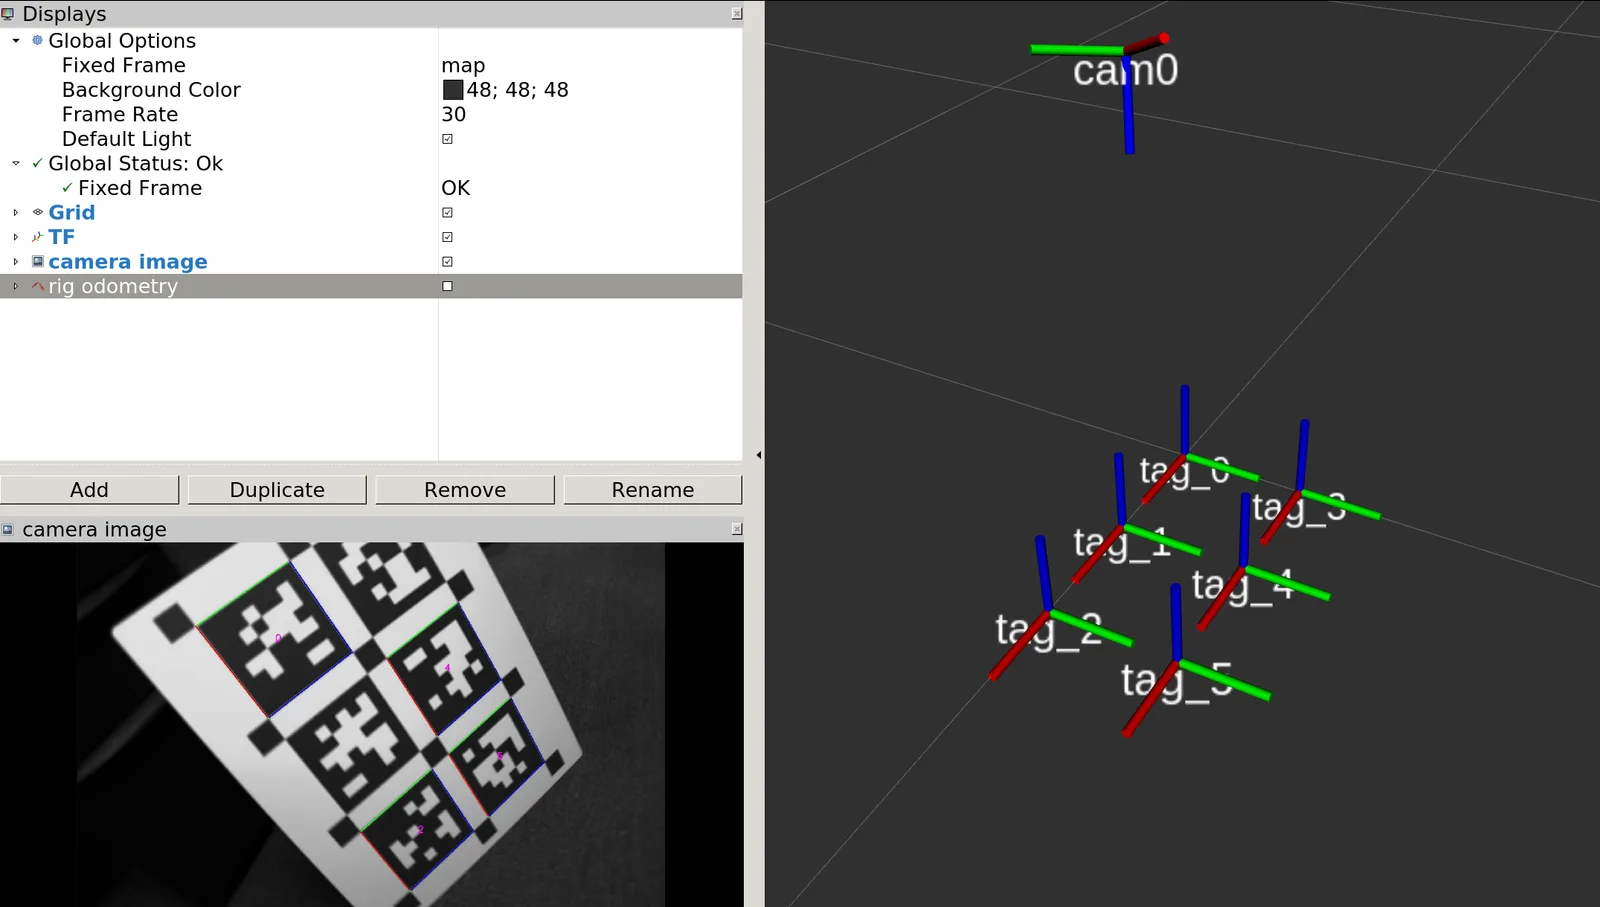 Lo que entrega el detector: cada marcador con su ID y sus tres ejes, ya en metros. Captura: TagSLAM, Apache-2.0.
Del marcador al robot
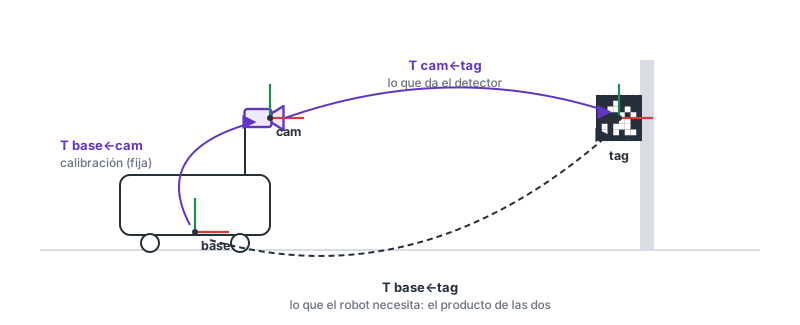
El detector entrega la pose del marcador respecto a la cámara, . Sin embargo, lo que el robot necesita es la posición del marcador respecto a su propia base. Para obtenerla se componen las dos transformaciones:
En ROS 2 esta cadena de transformaciones se maneja con tf2. La cámara publica su imagen junto con su calibración, el detector publica un marco por cada marcador, y el componente que la consume, por ejemplo el acoplamiento a la estación de carga de Nav2, la localización o el planificador del brazo, pide la transformación que necesita con su marca de tiempo. Un error frecuente está en los ejes: el marco óptico de la cámara mira a lo largo de , mientras que el marco del cuerpo del robot mira a lo largo de . Además, el eje del marcador apunta hacia dentro en AprilTag y hacia fuera en ArUco. Antes de combinar dos poses conviene confirmar en qué marco está cada una.
Calibración mano-ojo
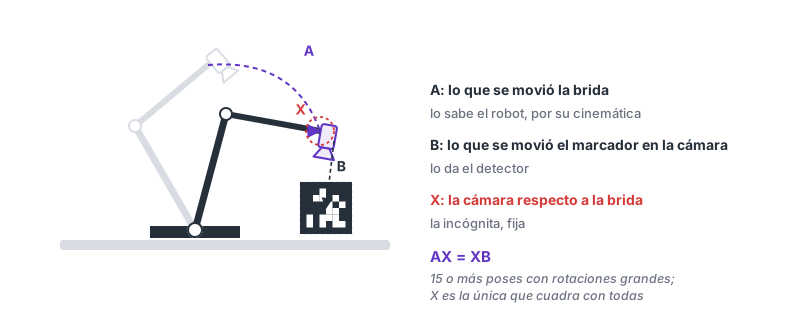
Cuando la cámara va montada en la muñeca de un brazo, hace falta conocer la transformación fija entre la cámara y la brida del robot, y no es algo que se pueda medir con una regla. Se resuelve planteando la ecuación : el brazo pasa por varias poses; en cada una se registra el movimiento de la brida, que el robot conoce, y el movimiento del marcador visto por la cámara, y es la única transformación consistente con todos los pares. OpenCV lo resuelve con calibrateHandEye y MoveIt lo integra en RViz. Para esta calibración el marcador debe estar cerca y de frente a la cámara.
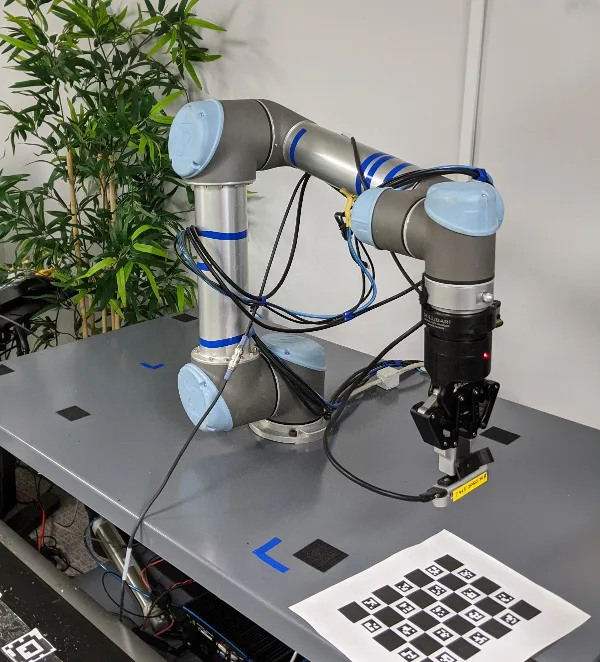 El montaje real: cámara en la muñeca y tablero fijo en la mesa. Foto: MoveIt, BSD-3.
Varios marcadores
Si se cuenta con un mapa donde la pose de cada marcador es conocida, cada cuadro se resuelve como un solo problema PnP usando todas las esquinas visibles. Si el mapa no existe, TagSLAM lo construye optimizando al mismo tiempo las poses del robot y las de los marcadores. Más marcadores no siempre es mejor: uno lejano o muy inclinado aporta más ruido que información, y uno mal medido en el mapa afecta a los demás. Lo que ayuda son marcadores bien visibles y colocados en planos distintos.
Del marcador a la acción
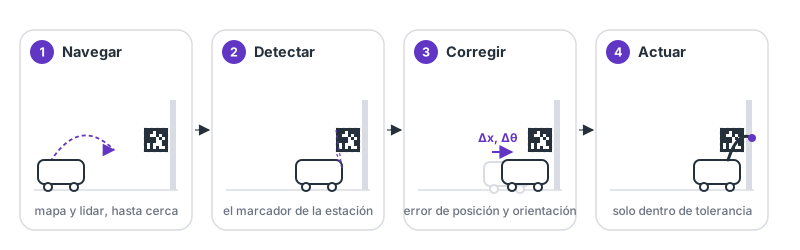
El error de reproyección, es decir, la diferencia entre dónde deberían caer las esquinas según la pose calculada y dónde se detectaron, es el indicador de confianza. Si aumenta, algo está mal: la calibración, el tamaño declarado o un marcador doblado. Con una pose confiable, el caso típico de una estación de trabajo sigue siempre los mismos pasos:
- El robot navega hasta una zona aproximada usando su mapa y su lidar.
- Detecta el marcador de la estación.
- Estima el error en posición y orientación respecto a donde debería estar.
- Corrige su posición, verifica que quedó dentro de la tolerancia y solo entonces actúa.
En manipulación el marcador suele usarse dos veces. Una cámara fija en la base del robot da una pose aproximada y el brazo se acerca; después, una cámara en la muñeca vuelve a ver el marcador y corrige en lazo cerrado hasta la posición final.
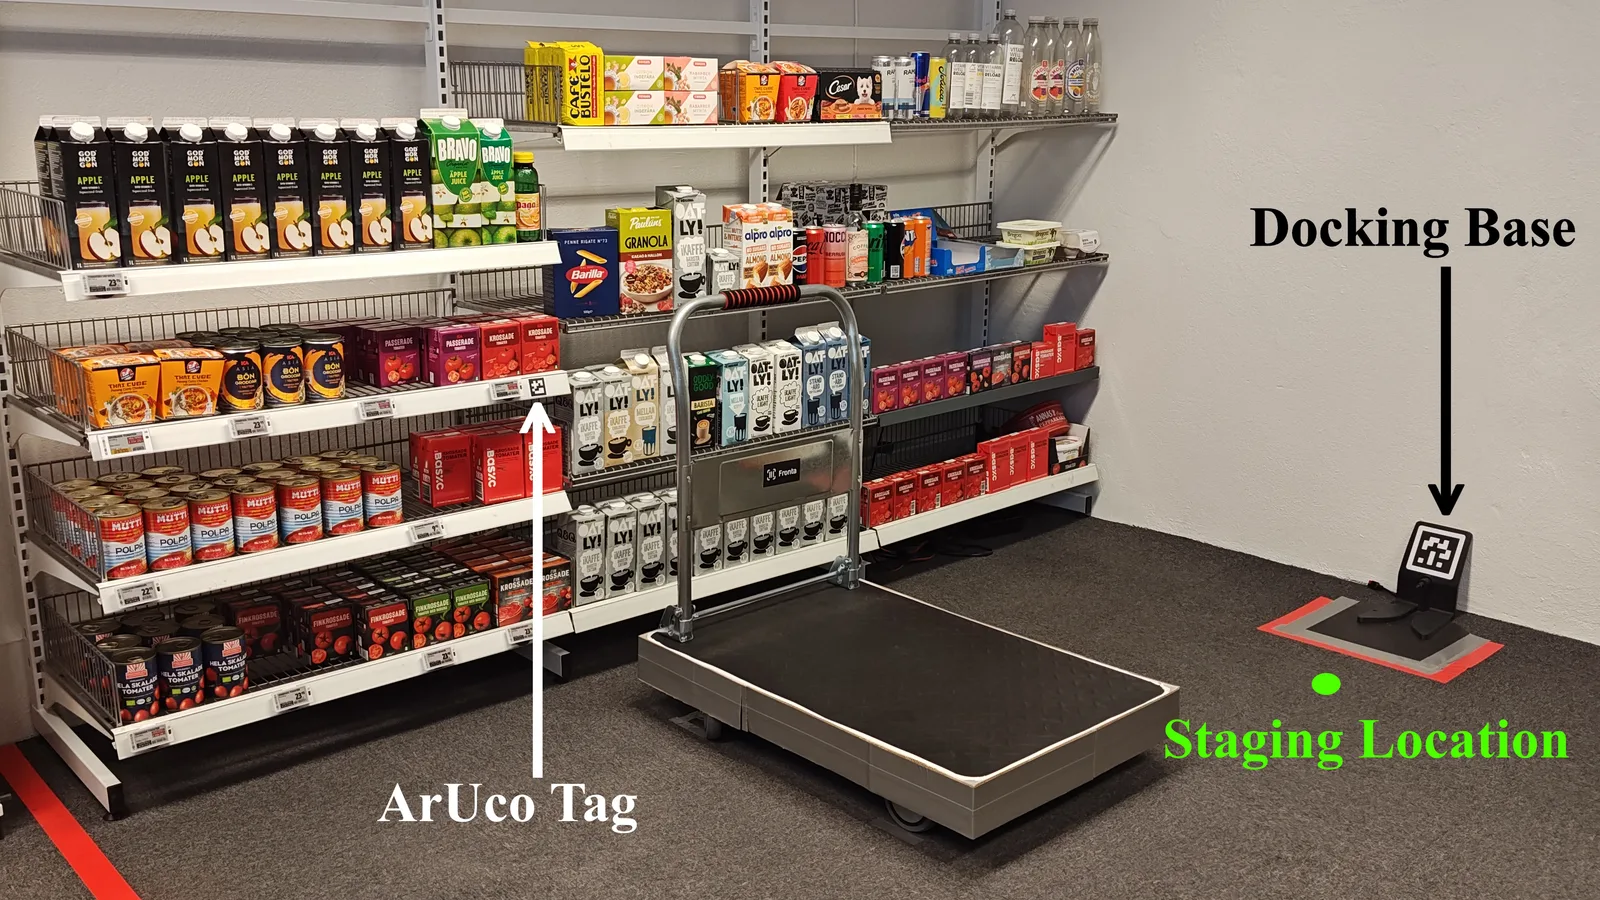 Una estación real: un marcador en el estante para la pieza y otro en el piso para el acoplamiento. Foto: From Pixels to Shelf, CC BY 4.0.
Estrategias de colocación
Diferentes formas de poner los marcadores
AUn marcador
- Qué resuelve:
- Dar a una cámara una referencia con identidad y tamaño conocidos: dónde está una pieza, una estación o el robot respecto a ella.
- Principio:
- Cuatro esquinas en píxeles y el tamaño físico bastan para resolver la pose (PnP, normalmente IPPE para planos).
- Ventaja:
- Lo más simple y barato; una sola transformación que publicar en tf2.
- Límite:
- Visto de frente la orientación es ambigua (dos poses casi iguales) y basta un píxel de ruido para que salte. La profundidad empeora con el cuadrado de la distancia.
- Ejemplo documentado:
- Spot usa un solo AprilTag 36h11 de 146 mm por estación de carga y por punto de inicialización de misión.
BVarios marcadores en un plano
- Qué resuelve:
- Más puntos, más robustez a oclusión y a ruido, sin construir nada en 3D: tableros, mesas, paredes.
- Principio:
- Todas las esquinas visibles entran en un solo PnP (EPnP); si uno se tapa, los demás sostienen la solución.
- Ventaja:
- Precisión de traslación mejor que con uno solo y detección parcial tolerada. Es la lógica del tablero ChArUco y de los campos de competencia con 16 AprilTags.
- Límite:
- Sigue siendo un plano: la ambigüedad de orientación de frente no desaparece del todo, y un marcador lejano o muy inclinado puede meter más ruido del que aporta.
- Ejemplo documentado:
- PhotonVision MultiTag resuelve la pose del robot con todos los AprilTags visibles del campo de FRC a la vez, usando su distribución conocida.
CBundle rígido
- Qué resuelve:
- Tratar varios marcadores como un solo objeto con un marco de referencia común (el dock, la estación, el fixture).
- Principio:
- Las poses relativas entre marcadores se miden una vez (calibración del bundle) y después cada frame estima la pose del conjunto con todas las esquinas visibles.
- Ventaja:
- Una sola pose estable aunque falten marcadores; la salida no cambia de marco cuando cambia el marcador visible.
- Límite:
- Si la geometría del bundle está mal medida, todo el sistema hereda ese error; apriltag_ros lo resuelve con un script de calibración y TagSLAM optimizándola junto con el resto.
- Ejemplo documentado:
- apriltag_ros define tag bundles con la pose de cada tag respecto al marco del bundle; Stretch 4 acopla con tres ArUco de 50 mm en su estación.
DDistribución en 3D
- Qué resuelve:
- Ver el objeto desde cualquier lado y eliminar la ambigüedad de orientación.
- Principio:
- Marcadores en caras distintas de un prisma o cubo: los puntos ya no son coplanares, y PnP con puntos no coplanares tiene solución única.
- Ventaja:
- Pose completa y sin saltos mientras se vean dos caras; el objeto se sigue al girar.
- Límite:
- Hay que fabricar y calibrar la pieza; cada cara con tag ocupa espacio en el objeto.
- Ejemplo documentado:
- El "exoesqueleto fiducial" (2026) monta un tag en cada eslabón de un brazo barato y recupera la pose de cada eslabón y los ángulos articulares desde una sola imagen RGB.
EArreglo asimétrico
- Qué resuelve:
- Que la disposición misma diga qué lado es cuál, aunque un marcador no se lea.
- Principio:
- Tres arriba y dos abajo, o un triángulo irregular: ninguna rotación del conjunto coincide consigo misma, así que la geometría relativa confirma la identidad y descarta falsos positivos.
- Ventaja:
- Redundancia y verificación mutua: si un marcador se lee mal, su posición respecto a los otros lo delata.
- Límite:
- Es una variante del bundle (C): necesita la misma calibración de geometría, y los marcadores más alejados de la cámara aportan menos.
- Ejemplo documentado:
- Los docks de robots de servicio suelen combinar un marcador central con otros laterales a distinta altura; Stretch 4 usa derecho, izquierdo y ápice.
FMultiescala
- Qué resuelve:
- Verlo desde lejos y seguir viéndolo a 20 cm, cuando el grande ya no cabe en la imagen.
- Principio:
- Un marcador grande para el acercamiento y uno pequeño (o uno recursivo, anidado en el hueco del grande) para la fase final; el sistema cambia de referencia sin perder la pose.
- Ventaja:
- Rango de distancias de más de 100 a 1 con una sola cámara. AprilTag 3 localizó un dron sobre un tag anidado de 90 cm desde 0.08 hasta 16 m.
- Límite:
- La transición entre marcadores tiene que estar en el software (qué pose manda cuando se ven los dos); la precisión de cada uno sigue dependiendo de sus píxeles.
- Ejemplo documentado:
- Las familias recursivas tagCustom48h12 y los marcadores fractales de ArUco; en aterrizaje de drones, tags grandes con uno pequeño en el centro.
GDistribuidos en el entorno
- Qué resuelve:
- Localizar al robot en un edificio o nave con una referencia absoluta e inequívoca, sin depender de que el SLAM no se confunda.
- Principio:
- Cada marcador tiene una pose conocida en el mapa; ver uno da la pose del robot, ver varios la refina, y volver a ver uno cierra el bucle.
- Ventaja:
- Resuelve el robot secuestrado al arrancar y los pasillos iguales; con TagSLAM el mapa de marcadores se construye solo.
- Límite:
- Infraestructura que mantener: si alguien mueve un marcador, el mapa miente. Por eso MiR, OTTO o Seegrid venden navegación sin marcadores, y los usan solo en docks.
- Ejemplo documentado:
- Spot GraphNav con fiduciales en paredes a 45–60 cm del piso; Amazon Kiva con un código 2D cada metro en el piso; Monumental con stickers de localización en obra.
HReferencia para manipular
- Qué resuelve:
- Saber dónde está exactamente la bandeja, el fixture, la herramienta o la pieza respecto a la cámara del brazo, para agarrarla.
- Principio:
- El marcador va en el objeto o en su soporte; la pose del tag se transforma a la base del robot con la calibración mano-ojo, y una cámara en la muñeca refina la aproximación final.
- Ventaja:
- Pose métrica de objetos sin entrenar nada; funciona con piezas sin textura o translúcidas que un detector aprendido no resuelve.
- Límite:
- Solo sirve para lo que lleva marcador; cualquier error de hand-eye se traslada entero al agarre. Es lo que FoundationPose y similares empiezan a sustituir.
- Ejemplo documentado:
- Stretch lleva ArUco de 14 mm en las puntas de la pinza para verla desde la cámara de cabeza; los tutoriales de hand-eye de MoveIt y de NVIDIA usan ChArUco en la mesa o en la muñeca.
Casos de uso
Docking, localización en naves y obras, calibración de brazos, manipulación. Cada foto y cada video traen el caso detrás: lo que la fuente documenta, lo que se deduce y lo que falta por confirmar.
Fotografías
Instalaciones reales con los marcadores a la vista. Cada una con su fuente y su licencia; al abrirla, el caso de uso.
Videos
Demostraciones y tutoriales con los marcadores en acción. El video se carga solo cuando lo pulsas.
Docking
Autonomous Docking with AprilTags Using Nav2 - ROS 2 Jazzy
Automatic Addison
Tutorial de docking autónomo: un AprilTag en la estación da la pose que usa el Docking Server de Nav2 para acercarse y acoplarse.
Por qué está aquí: Es el camino estándar en ROS 2 para hacer docking con un marcador, paso a paso y con el código del tutorial.
Abrir en YouTube ›Caso de uso: Manipulador móvil con dos UR10: docking por servo visual
Caso de uso · Configuraciones: A, H
Manipulador móvil con dos UR10: docking por servo visual
Tecnalia (Sensors, 2019)
Una base omnidireccional con dos brazos UR10 se acopla a estaciones de trabajo con un marcador fiducial y control visual proporcional; 29 de 30 acoples frente a 14 de 30 con SLAM solo.
Hecho documentado
- Cámara IDS uEye GigE al frente; la pose del marcador se estima en la cámara y se transforma a la base para ser independiente del montaje; lazo de control a 20 Hz.
- Docking estático: 29/30 éxitos (SLAM solo: 14/30). Docking sobre plataforma en movimiento: error menor de 1 cm en unos 2 s; errores medios de 9.1 mm longitudinal y 10.7 mm lateral.
- El fallo registrado se debió a sol reflejado en el marcador.
Interpretación técnica
- Es el patrón industrial completo: SLAM para llegar cerca, marcador para los últimos centímetros, y el marcador como realimentación continua, no solo como medida inicial.
Fuentes
Tecnalia · Outón et al., Innovative Mobile Manipulator Solution for Modern Flexible Manufacturing Processes, Sensors 2019 · CC BY 4.0 · 2026-10-18
Docking
Nova Carter - Nav2 & New Auto-Docking Server!
Steve Macenski
El robot Nova Carter de NVIDIA acoplándose con el Docking Server de Nav2. El paquete nova_carter_docking usa el detector de AprilTag en GPU de Isaac ROS y publica la pose de un tag36h11 de 6 pulgadas al frente del dock.
Por qué está aquí: Docking de producto con un solo marcador y detección en GPU; el anuncio en ROS Discourse reporta más del 98 % de éxito.
Abrir en YouTube ›Caso de uso: Manipulador móvil con dos UR10: docking por servo visual
Caso de uso · Configuraciones: A, H
Manipulador móvil con dos UR10: docking por servo visual
Tecnalia (Sensors, 2019)
Una base omnidireccional con dos brazos UR10 se acopla a estaciones de trabajo con un marcador fiducial y control visual proporcional; 29 de 30 acoples frente a 14 de 30 con SLAM solo.
Hecho documentado
- Cámara IDS uEye GigE al frente; la pose del marcador se estima en la cámara y se transforma a la base para ser independiente del montaje; lazo de control a 20 Hz.
- Docking estático: 29/30 éxitos (SLAM solo: 14/30). Docking sobre plataforma en movimiento: error menor de 1 cm en unos 2 s; errores medios de 9.1 mm longitudinal y 10.7 mm lateral.
- El fallo registrado se debió a sol reflejado en el marcador.
Interpretación técnica
- Es el patrón industrial completo: SLAM para llegar cerca, marcador para los últimos centímetros, y el marcador como realimentación continua, no solo como medida inicial.
Fuentes
Tecnalia · Outón et al., Innovative Mobile Manipulator Solution for Modern Flexible Manufacturing Processes, Sensors 2019 · CC BY 4.0 · 2026-10-18
Varios marcadores
TagSLAM: SLAM based on April Tags
Shalik AI
Presentación de TagSLAM, el paquete de Bernd Pfrommer para localizar y mapear con muchos AprilTags y varias cámaras usando un grafo de factores.
Por qué está aquí: Explica cómo varios marcadores se convierten en un mapa y una trayectoria optimizados a la vez, en lugar de poses sueltas.
Abrir en YouTube ›Caso de uso: TagSLAM: el mapa de tags se estima en vez de medirse
Caso de uso · Configuraciones: C, G
TagSLAM: el mapa de tags se estima en vez de medirse
Universidad de Pensilvania (Pfrommer y Daniilidis)
Un grafo de factores sobre GTSAM en el que cada tag pertenece a un cuerpo; las poses relativas se descubren cuando varios tags aparecen en el mismo cuadro, y sirve también para calibrar cámaras sin campo de visión común.
Hecho documentado
- Los cuerpos pueden ser estáticos (laboratorio) o dinámicos (un bloque, un rig de cámaras); las poses tag→cuerpo son estáticas y se optimizan; permite calibrar extrínsecos multicámara sin solape.
- El README lista como síntomas de error "grandes errores de reproyección" por calibración, tamaño o pose de tag equivocados.
Interpretación técnica
- Resuelve la limitación práctica de los bundles (medir la geometría con regla): la geometría se vuelve una incógnita más del problema.
Fuentes
B. Pfrommer, K. Daniilidis · TagSLAM: Robust SLAM with Fiducial Markers (arXiv 1910.00679) · arXiv (ver licencia del artículo) · 2026-10-18
B. Pfrommer · TagSLAM (web y conceptos) · Proyecto abierto · 2026-10-18
Localización
TagSLAM loop closure
Bernd Pfrommer
Cierre de bucle sobre odometría visual-inercial usando las detecciones de AprilTags como restricciones del grafo.
Por qué está aquí: Se ve el efecto concreto de volver a ver un marcador conocido: la deriva acumulada se corrige de golpe.
Abrir en YouTube ›Caso de uso: TagSLAM: el mapa de tags se estima en vez de medirse
Caso de uso · Configuraciones: C, G
TagSLAM: el mapa de tags se estima en vez de medirse
Universidad de Pensilvania (Pfrommer y Daniilidis)
Un grafo de factores sobre GTSAM en el que cada tag pertenece a un cuerpo; las poses relativas se descubren cuando varios tags aparecen en el mismo cuadro, y sirve también para calibrar cámaras sin campo de visión común.
Hecho documentado
- Los cuerpos pueden ser estáticos (laboratorio) o dinámicos (un bloque, un rig de cámaras); las poses tag→cuerpo son estáticas y se optimizan; permite calibrar extrínsecos multicámara sin solape.
- El README lista como síntomas de error "grandes errores de reproyección" por calibración, tamaño o pose de tag equivocados.
Interpretación técnica
- Resuelve la limitación práctica de los bundles (medir la geometría con regla): la geometría se vuelve una incógnita más del problema.
Fuentes
B. Pfrommer, K. Daniilidis · TagSLAM: Robust SLAM with Fiducial Markers (arXiv 1910.00679) · arXiv (ver licencia del artículo) · 2026-10-18
B. Pfrommer · TagSLAM (web y conceptos) · Proyecto abierto · 2026-10-18
Varios marcadores
TagSLAM state estimation of block
Bernd Pfrommer
Estimación de la pose de un bloque que lleva varios marcadores, tratado como un cuerpo rígido en TagSLAM.
Por qué está aquí: Es el ejemplo canónico de bundle: varios tags en caras distintas dan una pose única y estable del objeto.
Abrir en YouTube ›Caso de uso: TagSLAM: el mapa de tags se estima en vez de medirse
Caso de uso · Configuraciones: C, G
TagSLAM: el mapa de tags se estima en vez de medirse
Universidad de Pensilvania (Pfrommer y Daniilidis)
Un grafo de factores sobre GTSAM en el que cada tag pertenece a un cuerpo; las poses relativas se descubren cuando varios tags aparecen en el mismo cuadro, y sirve también para calibrar cámaras sin campo de visión común.
Hecho documentado
- Los cuerpos pueden ser estáticos (laboratorio) o dinámicos (un bloque, un rig de cámaras); las poses tag→cuerpo son estáticas y se optimizan; permite calibrar extrínsecos multicámara sin solape.
- El README lista como síntomas de error "grandes errores de reproyección" por calibración, tamaño o pose de tag equivocados.
Interpretación técnica
- Resuelve la limitación práctica de los bundles (medir la geometría con regla): la geometría se vuelve una incógnita más del problema.
Fuentes
B. Pfrommer, K. Daniilidis · TagSLAM: Robust SLAM with Fiducial Markers (arXiv 1910.00679) · arXiv (ver licencia del artículo) · 2026-10-18
B. Pfrommer · TagSLAM (web y conceptos) · Proyecto abierto · 2026-10-18
Varios marcadores
Factor Graphs + TagSLAM For Efficient Map and Pose Optimization
Embodied Intelligence
Explicación de grafos de factores aplicados a TagSLAM con el dataset PennCOSYVIO, un recorrido con AprilTags distribuidos por el campus.
Por qué está aquí: Une la teoría (grafo de factores) con un caso de marcadores distribuidos en un entorno grande.
Abrir en YouTube ›Caso de uso: TagSLAM: el mapa de tags se estima en vez de medirse
Caso de uso · Configuraciones: C, G
TagSLAM: el mapa de tags se estima en vez de medirse
Universidad de Pensilvania (Pfrommer y Daniilidis)
Un grafo de factores sobre GTSAM en el que cada tag pertenece a un cuerpo; las poses relativas se descubren cuando varios tags aparecen en el mismo cuadro, y sirve también para calibrar cámaras sin campo de visión común.
Hecho documentado
- Los cuerpos pueden ser estáticos (laboratorio) o dinámicos (un bloque, un rig de cámaras); las poses tag→cuerpo son estáticas y se optimizan; permite calibrar extrínsecos multicámara sin solape.
- El README lista como síntomas de error "grandes errores de reproyección" por calibración, tamaño o pose de tag equivocados.
Interpretación técnica
- Resuelve la limitación práctica de los bundles (medir la geometría con regla): la geometría se vuelve una incógnita más del problema.
Fuentes
B. Pfrommer, K. Daniilidis · TagSLAM: Robust SLAM with Fiducial Markers (arXiv 1910.00679) · arXiv (ver licencia del artículo) · 2026-10-18
B. Pfrommer · TagSLAM (web y conceptos) · Proyecto abierto · 2026-10-18
Localización
Tutorial for debugging VIO positioning fused with AprilTag as fiducial markers on VOXL
ModalAI
Cómo depurar la fusión entre odometría visual-inercial y AprilTags fijos de pose conocida en la plataforma VOXL.
Por qué está aquí: Muestra el uso del marcador como ancla que corrige la deriva de un estimador relativo, no como único sensor.
Abrir en YouTube ›Calibración
3 - MoveIt - Easy Hand Eye Calibration with MoveIt
PickNik Robotics
Presentación de MoveIt Calibration, la herramienta de calibración cámara-robot integrada en RViz. El paquete soporta tableros ArUco y ChArUco y recomienda ChArUco.
Por qué está aquí: Es la calibración mano-ojo que un brazo industrial necesita antes de usar cualquier marcador para agarrar.
Abrir en YouTube ›Caso de uso: AprilCube y el exoesqueleto fiducial: tags en 3D para brazos
Caso de uso · Configuraciones: D
AprilCube y el exoesqueleto fiducial: tags en 3D para brazos
MIT (AprilCube) y Fiducial Exoskeletons (2026)
Cubos imprimibles con tags en las seis caras para calibrar la cámara respecto al brazo, y un marcador por eslabón que recupera los ángulos articulares desde una sola imagen.
Hecho documentado
- AprilCube: cubos y formas por vóxeles con ArUco o AprilTag en las caras, usados como objetivo en el flange de brazos Franka y Flexiv para calibrar una cámara fija.
- Fiducial Exoskeletons: un ArUco por eslabón y uno en la base de un brazo SO-100; ángulos articulares por optimización consistente con la cinemática; éxito de agarre 9/10 frente a 4/10 con calibración de pose promedio; error de traslación de cámara de 5.3 mm.
- Un trabajo de manipulación de 2026 usa un cubo con 24 tags 36h11 (cuatro por cara) y solo publica pose si ve al menos tres.
Interpretación técnica
- La distribución en 3D elimina la ambigüedad del plano y aguanta que la mano tape parte del objeto; el precio son las tolerancias de impresión, que entran como error del bundle.
Fuentes
Y. Park, P. Agrawal (MIT) · AprilCube (repositorio) · Ver repositorio · 2026-10-18
arXiv · Fiducial Exoskeletons (arXiv 2601.08034) · arXiv (ver licencia del artículo) · 2026-10-18
arXiv · Cross-Embodiment Robot Manipulation via a Unified Hand Action Space (arXiv 2607.03570) · arXiv (ver licencia del artículo) · 2026-10-18
Calibración
Hand Eye Calibration using Aruco Marker
Pacific Aquatech
Calibración mano-ojo automática con un marcador ArUco fijado al brazo y una cámara externa (eye-to-hand).
Por qué está aquí: La variante con cámara fija y marcador en el robot, complementaria a la de cámara en la muñeca.
Abrir en YouTube ›Caso de uso: AprilCube y el exoesqueleto fiducial: tags en 3D para brazos
Caso de uso · Configuraciones: D
AprilCube y el exoesqueleto fiducial: tags en 3D para brazos
MIT (AprilCube) y Fiducial Exoskeletons (2026)
Cubos imprimibles con tags en las seis caras para calibrar la cámara respecto al brazo, y un marcador por eslabón que recupera los ángulos articulares desde una sola imagen.
Hecho documentado
- AprilCube: cubos y formas por vóxeles con ArUco o AprilTag en las caras, usados como objetivo en el flange de brazos Franka y Flexiv para calibrar una cámara fija.
- Fiducial Exoskeletons: un ArUco por eslabón y uno en la base de un brazo SO-100; ángulos articulares por optimización consistente con la cinemática; éxito de agarre 9/10 frente a 4/10 con calibración de pose promedio; error de traslación de cámara de 5.3 mm.
- Un trabajo de manipulación de 2026 usa un cubo con 24 tags 36h11 (cuatro por cara) y solo publica pose si ve al menos tres.
Interpretación técnica
- La distribución en 3D elimina la ambigüedad del plano y aguanta que la mano tape parte del objeto; el precio son las tolerancias de impresión, que entran como error del bundle.
Fuentes
Y. Park, P. Agrawal (MIT) · AprilCube (repositorio) · Ver repositorio · 2026-10-18
arXiv · Fiducial Exoskeletons (arXiv 2601.08034) · arXiv (ver licencia del artículo) · 2026-10-18
arXiv · Cross-Embodiment Robot Manipulation via a Unified Hand Action Space (arXiv 2607.03570) · arXiv (ver licencia del artículo) · 2026-10-18
Calibración
TagSLAM extrinsic calibration
Bernd Pfrommer
Calibración extrínseca entre cámaras usando AprilTags vistos a la vez, con TagSLAM.
Por qué está aquí: Los marcadores sirven para calibrar varias cámaras entre sí, no solo para localizar.
Abrir en YouTube ›Caso de uso: TagSLAM: el mapa de tags se estima en vez de medirse
Caso de uso · Configuraciones: C, G
TagSLAM: el mapa de tags se estima en vez de medirse
Universidad de Pensilvania (Pfrommer y Daniilidis)
Un grafo de factores sobre GTSAM en el que cada tag pertenece a un cuerpo; las poses relativas se descubren cuando varios tags aparecen en el mismo cuadro, y sirve también para calibrar cámaras sin campo de visión común.
Hecho documentado
- Los cuerpos pueden ser estáticos (laboratorio) o dinámicos (un bloque, un rig de cámaras); las poses tag→cuerpo son estáticas y se optimizan; permite calibrar extrínsecos multicámara sin solape.
- El README lista como síntomas de error "grandes errores de reproyección" por calibración, tamaño o pose de tag equivocados.
Interpretación técnica
- Resuelve la limitación práctica de los bundles (medir la geometría con regla): la geometría se vuelve una incógnita más del problema.
Fuentes
B. Pfrommer, K. Daniilidis · TagSLAM: Robust SLAM with Fiducial Markers (arXiv 1910.00679) · arXiv (ver licencia del artículo) · 2026-10-18
B. Pfrommer · TagSLAM (web y conceptos) · Proyecto abierto · 2026-10-18
Manipulación
SIRA Hat Pickup Demo
INSPIRE Lab
Un Stretch localiza un marcador ArUco en un sombrero en el piso, lo recoge y busca un segundo ArUco que lleva la persona para calcular la pose de entrega.
Por qué está aquí: Manipulación móvil completa guiada por marcadores: navegar, detectar, agarrar y entregar, con código abierto.
Abrir en YouTube ›Manipulación
TurtleBot3 81 ROS 2 Humble Home Service Challenge
ROBOTIS OpenSourceTeam
Manipulador móvil TurtleBot3 con OpenMANIPULATOR haciendo pick-and-place guiado por marcadores ArUco, en simulación y en robot real.
Por qué está aquí: Un manipulador móvil barato y reproducible con el mismo flujo que los grandes: base, cámara, marcador, brazo.
Abrir en YouTube ›Manipulación
Visual servoing using April Tags: tackling a dishwasher with Tiago
HUCEBOT @ Inria
Control visual (visual servoing) de un TIAGo con AprilTags para manipular un lavavajillas, proyecto de pasantía en el equipo HUCEBOT de Inria.
Por qué está aquí: El marcador no solo da una pose inicial: cierra el lazo de control del brazo mientras se mueve.
Abrir en YouTube ›Caso de uso: TIAGo: ArUco en la caja, MoveIt para agarrarla
Caso de uso · Configuraciones: A, H
TIAGo: ArUco en la caja, MoveIt para agarrarla
PAL Robotics
El tutorial oficial de pick-and-place de TIAGo pone un marcador ArUco en la caja; un nodo reconstruye su pose desde la cámara de la cabeza y MoveIt planifica el agarre.
Hecho documentado
- El nodo aruco_single estima la pose 3D del marcador a partir de la imagen RGB de la cámara de cabeza; el cliente espera a ver el marcador antes de enviar la meta al servidor de pick-and-place basado en MoveIt.
- El paquete tiago_aruco_demo está en el repositorio público tiago_tutorials.
Interpretación técnica
- Es la configuración H en su forma mínima: un marcador en el objeto, la pose transformada a la base vía tf, y el brazo en lazo abierto. Sirve para enseñar; en producción haría falta refinar con una cámara de muñeca.
Fuentes
PAL Robotics · TIAGo Tutorials: Pick & Place (ROS Wiki) · CC BY 3.0 (ROS Wiki) · 2026-10-18
PAL Robotics · pal-robotics/tiago_tutorials · Repositorio público · 2026-10-18
Manipulación
UR Robot - Object (Aruco Marker) Tracking with universal robot UR3
CTAI PUJ BOGOTA
Un brazo UR3 sigue en tiempo real un objeto que lleva un marcador ArUco, en la Pontificia Universidad Javeriana de Bogotá.
Por qué está aquí: Seguimiento de pose con un cobot industrial, hecho en un laboratorio universitario hispanohablante.
Abrir en YouTube ›Caso de uso: Cobots UR con cámara de muñeca: el tag como desplazamiento visual
Caso de uso · Configuraciones: A, H
Cobots UR con cámara de muñeca: el tag como desplazamiento visual
Universal Robots + Robotiq
La Wrist Camera de Robotiq usa un tag como referencia para desplazar el programa del brazo cuando una bandeja o un fixture no están exactamente donde se programaron.
Hecho documentado
- La función "Visual Offset" toma el tag de Robotiq como referencia; la calibración con tablero valida 9 poses y pide recalibrar si el error supera ±4 mm.
Interpretación técnica
- Es eye-in-hand de producción: el brazo mira el tag, calcula la diferencia con la pose enseñada y corrige todo el programa, sin cambiar la cinemática ni el fixture.
Fuentes
Robotiq · Robotiq Wrist Camera, Vision System manual · Manual del fabricante · 2026-10-18
Laboratorio
RoboEye - grasping experiment 1
claver
Brazo TinkerKit Braccio con cámara USB calibrada: detecta marcadores ArUco, estima su pose por PnP y la usa como objetivo del planificador para agarrar objetos.
Por qué está aquí: Todo el pipeline (calibración, detección, PnP, cinemática inversa) con hardware de menos de 100 euros y código abierto.
Abrir en YouTube ›Laboratorio
Fix fiducial marker pose ambiguity using RGBD data (AprilTag 3)
Catree
La ambigüedad de pose de un marcador plano visto de frente, y cómo resolverla con la profundidad de una cámara RGB-D.
Por qué está aquí: Muestra el problema más común de los marcadores (el salto de orientación) y una de sus soluciones.
Abrir en YouTube ›Drones
ArduPilot and Realsense T265 - Precision Landing with AprilTag 3 (non-ROS)
Thien
Aterrizaje de precisión con ArduPilot: la cámara de una RealSense T265 detecta un AprilTag y envía mensajes LANDING_TARGET al autopiloto, sin ROS.
Por qué está aquí: El marcador como objetivo de aterrizaje: la variante aérea del docking.
Abrir en YouTube ›Drones
Precision Landing on Apriltag with ModalAI VOXL m500 PX4 Developer Drone
ModalAI
Un dron m500 cuyo VIO se inicializa a propósito desplazado y torcido aterriza igual con precisión sobre un AprilTag, gracias a la detección a bordo.
Por qué está aquí: Demuestra por qué el marcador es una referencia absoluta: corrige un estimador que empezó mal.
Abrir en YouTube ›Drones
Precision Landing using ArduPilot and BlueOS
Randy Mackay
Aterrizaje de precisión sobre una plataforma con AprilTag usando ArduPilot y la extensión de BlueOS, con gimbal y CubeOrange+.
Por qué está aquí: Viene de uno de los desarrolladores principales de ArduPilot; es la referencia del flujo oficial.
Abrir en YouTube ›Laboratorio
ROS 2: Nvidia Jetson Nano Accelerated Apriltag Detection is GREASED LIGHTNING
Savage Robots
Detección de AprilTags acelerada por GPU con Isaac ROS en un Jetson Nano.
Por qué está aquí: Qué cambia cuando el detector corre en GPU: la tasa de cuadros deja de ser el cuello de botella.
Abrir en YouTube ›