Leer un encoder de cuadratura con PIO en el RP2040 y el RP2350
Un encoder incremental de cuadratura entrega dos señales, A y B, desfasadas 90°. Cada ciclo de A tiene cuatro flancos entre las dos señales, y el orden en que aparecen indica el sentido de giro. Si cuentas los cuatro flancos (decodificación x4), un encoder de 600 pulsos por vuelta (PPR) da 2400 cuentas por vuelta (CPR).
Leerlo bien a baja velocidad es fácil. El problema aparece cuando el motor gira rápido y el microcontrolador tiene otras cosas que hacer. En el RP2040 y el RP2350 la solución más limpia es dejar el conteo a una máquina de estados PIO, que lo hace sin usar la CPU.
Por qué el polling y las interrupciones pierden pasos
Hagamos la cuenta con un motor a 3000 rpm y ese encoder de 600 PPR:
Entre dos flancos hay 8.33 µs. Con polling, el programa tiene que leer los dos pines al menos una vez en cada intervalo. Basta un printf, una escritura a la memoria flash, una atención al Wi-Fi o una pasada del recolector de basura de MicroPython para saltarse uno o varios estados. Cuando se pierde un estado intermedio, el decodificador ve un salto de 00 a 11, que no indica sentido, y la cuenta se corrompe sin avisar.
Con interrupciones en los dos pines el problema cambia de forma. A 125 MHz y 120 000 interrupciones por segundo quedan unos 1042 ciclos entre una y otra, y en ese margen caben la entrada y salida de la ISR, las demás interrupciones del sistema y el resto del programa. En MicroPython los manejadores de Pin.irq son soft por defecto: se agendan para ejecutarse después y no en el momento del flanco, así que su retraso depende de lo que esté haciendo el intérprete.
Un PIO no tiene ninguno de estos problemas. Corre en paralelo a los núcleos, con tiempos fijos por instrucción, y solo entrega la cuenta cuando se la pides.
Cómo funciona el programa quadrature_encoder
El ejemplo pio/quadrature_encoder de pico-examples cabe en 24 instrucciones. Sin los comentarios largos, la parte PIO es esta:
.program quadrature_encoder
.origin 0

; estado 00
    JMP update    ; lee 00
    JMP decrement ; lee 01
    JMP increment ; lee 10
    JMP update    ; lee 11
; estado 01
    JMP increment ; lee 00
    JMP update    ; lee 01
    JMP update    ; lee 10
    JMP decrement ; lee 11
; estado 10
    JMP decrement ; lee 00
    JMP update    ; lee 01
    JMP update    ; lee 10
    JMP increment ; lee 11
; estado 11
    JMP update    ; lee 00
    JMP increment ; lee 01
decrement:
    JMP Y--, update ; lee 10
.wrap_target
update:
    MOV ISR, Y      ; lee 11
    PUSH noblock
sample_pins:
    OUT ISR, 2
    IN PINS, 2
    MOV OSR, ISR
    MOV PC, ISR
increment:
    MOV Y, ~Y
    JMP Y--, increment_cont
increment_cont:
    MOV Y, ~Y
.wrap
La idea es una tabla de saltos. El registro OSR guarda el estado anterior de los pines. OUT ISR, 2 pasa esos dos bits al ISR e IN PINS, 2 agrega los dos bits actuales, así que el ISR queda con un número de 4 bits:
MOV PC, ISR salta directo a esa dirección, y en cada una de las 16 entradas hay un salto a update (sin cambio o transición inválida), a increment o a decrement. Por eso el programa tiene que cargarse en la dirección 0, y de ahí el .origin 0. Las últimas dos entradas de la tabla se aprovechan como código: la dirección 14 es la instrucción de decremento y la 15 es update.
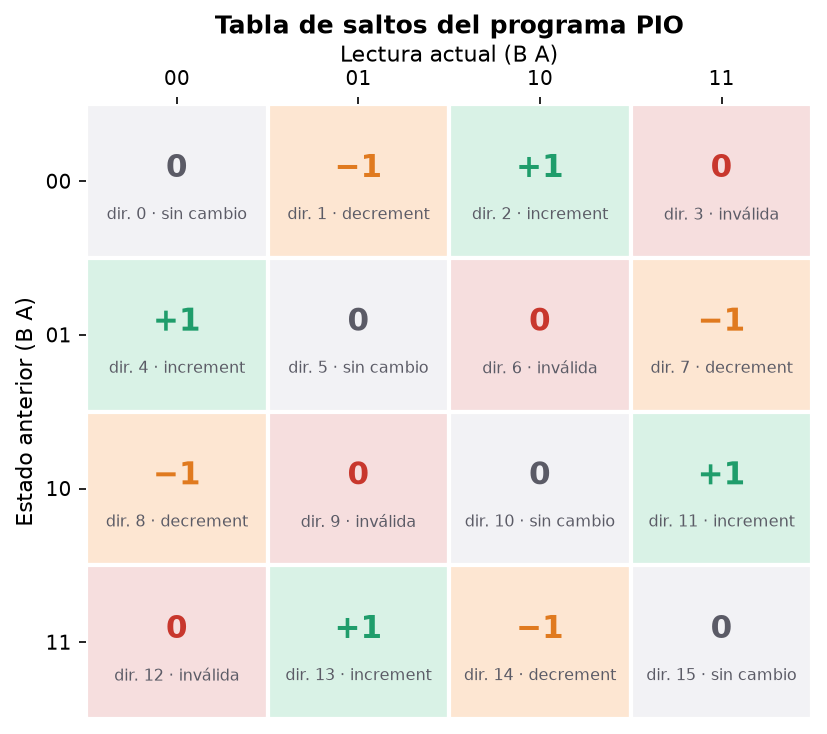
Las cuatro casillas en rojo son transiciones en las que cambiaron A y B a la vez. No dicen hacia dónde giró el eje, así que el programa las trata como si no hubiera cambio. Si aparecen en la práctica, es que se perdió un estado intermedio.
La cuenta vive en el registro Y. El PIO no tiene instrucción de incremento, pero sí JMP Y--, que decrementa Y. Para sumar uno, el programa invierte Y, lo decrementa y lo vuelve a invertir, porque en complemento a dos. El destino de esos JMP Y-- es siempre la instrucción siguiente, de modo que el salto no cambia el flujo y solo queda el efecto sobre Y.
En cada vuelta, MOV ISR, Y y PUSH noblock intentan meter la cuenta al FIFO de recepción. Si el FIFO está lleno, el dato se descarta y el programa sigue sin detenerse. La función que lee la cuenta vacía el FIFO y espera un dato nuevo, para no devolver un valor viejo.
La animación sale del emulador: el programa oficial recibe 16 pasos hacia adelante cada vez más rápidos, 10 hacia atrás y 6 hacia adelante. La cuenta que el programa empuja al FIFO sigue a la posición real paso por paso y termina en 12, igual que ella.
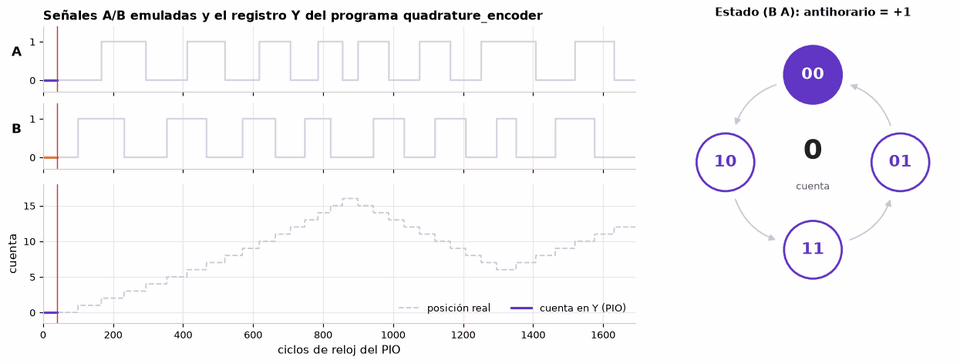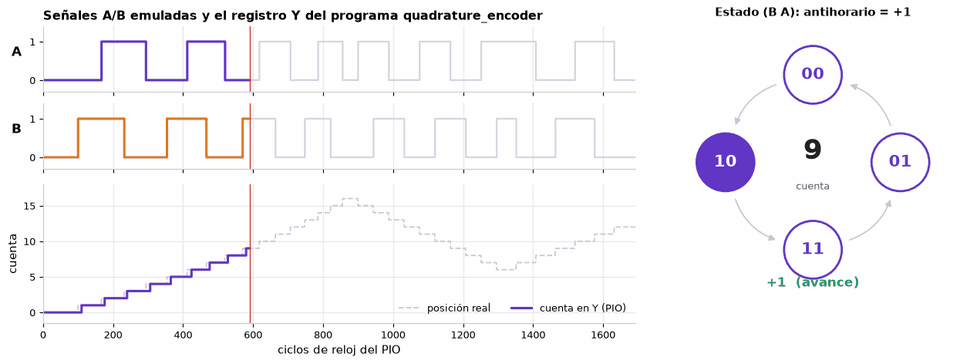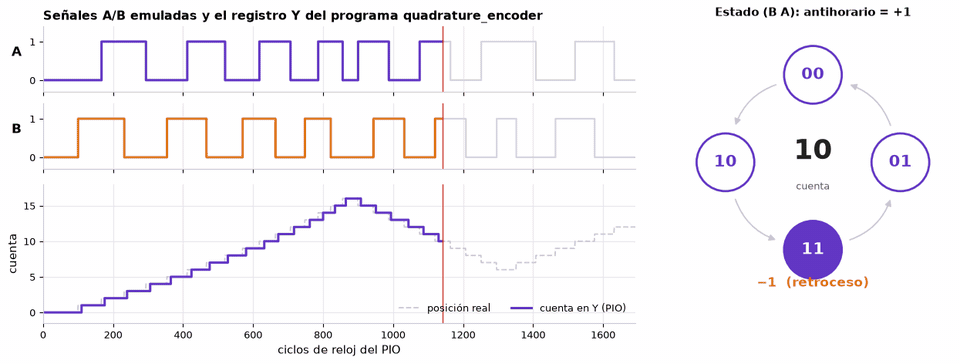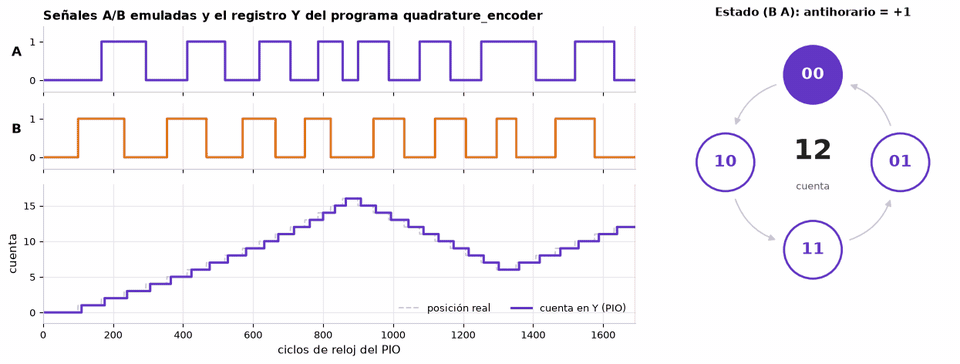
Contando ciclos desde un IN PINS hasta el siguiente, el camino sin cambio tarda 7 ciclos, el de decremento 8 y el de incremento 10. El peor caso, 10 ciclos, define el límite de velocidad que vemos más abajo.
Uso en C con el SDK
En el CMakeLists.txt el ejemplo genera el encabezado a partir del .pio y enlaza hardware_pio:
pico_generate_pio_header(mi_programa ${CMAKE_CURRENT_LIST_DIR}/quadrature_encoder.pio)
target_link_libraries(mi_programa PRIVATE pico_stdlib hardware_pio)
El .pio trae dos funciones en su bloque c-sdk. quadrature_encoder_program_init() configura los pines con pull-up y arranca la máquina de estados; el pin de B tiene que ser el siguiente al de A. quadrature_encoder_get_count() vacía el FIFO y regresa la cuenta. Con eso, un lazo que calcula la velocidad cada 10 ms queda así:
#include <stdio.h>
#include "pico/stdlib.h"
#include "hardware/pio.h"
#include "quadrature_encoder.pio.h"

#define PIN_A 10        // B va en el GPIO 11
#define CPR (4 * 600)   // cuentas por vuelta: 4 x PPR del encoder

int main() {
    stdio_init_all();
    PIO pio = pio0;
    const uint sm = 0;

    pio_add_program(pio, &quadrature_encoder_program);  // se carga en la dirección 0
    quadrature_encoder_program_init(pio, sm, PIN_A, 0); // 0 = reloj del PIO al máximo

    int32_t anterior = quadrature_encoder_get_count(pio, sm);
    absolute_time_t t_anterior = get_absolute_time();
    while (true) {
        sleep_ms(10);
        int32_t cuenta = quadrature_encoder_get_count(pio, sm);
        absolute_time_t t = get_absolute_time();
        // Resta en uint32_t: el resultado es correcto aunque la cuenta dé la vuelta
        int32_t delta = (int32_t)((uint32_t)cuenta - (uint32_t)anterior);
        float dt = absolute_time_diff_us(t_anterior, t) * 1e-6f;
        float rpm = (float)delta / CPR / dt * 60.0f;
        printf("cuenta %ld, delta %ld, %.1f rpm\n", (long)cuenta, (long)delta, rpm);
        anterior = cuenta;
        t_anterior = t;
    }
}
Cada bloque PIO tiene cuatro máquinas de estados que pueden compartir el mismo programa, así que un bloque lee hasta cuatro encoders. El RP2040 tiene dos bloques PIO y el RP2350 tiene tres.
Uso en MicroPython
MicroPython ensambla programas PIO con el decorador @rp2.asm_pio, pero no tiene .origin. El SDK, que MicroPython usa por debajo, busca espacio para cada programa empezando por el final de la memoria de 32 instrucciones, así que un programa de 24 quedaría en la dirección 8 y la tabla de saltos apuntaría a otro lado. La solución, la misma que usa Pololu en su biblioteca para el robot 3pi+ 2040, es rellenar con nop() hasta 32 instrucciones: un programa de ese tamaño solo cabe en la dirección 0.
Otro detalle es la dirección de corrimiento del OSR. El SDK la deja hacia la derecha por defecto y el programa depende de eso, porque OUT ISR, 2 tiene que sacar los dos bits bajos. En asm_pio el valor por defecto es hacia la izquierda, así que hay que indicarlo. En el emulador, con el corrimiento a la izquierda la cuenta salió mal incluso con transiciones lentas.
# Encoder de cuadratura con PIO en MicroPython (RP2040 / RP2350)
# Port del programa quadrature_encoder de pico-examples.
import rp2
from machine import Pin


@rp2.asm_pio(in_shiftdir=rp2.PIO.SHIFT_LEFT, out_shiftdir=rp2.PIO.SHIFT_RIGHT)
def quadrature_encoder():
    # Tabla de saltos: dirección = (estado anterior << 2) | estado nuevo
    jmp("update")        # 00 -> 00
    jmp("decrement")     # 00 -> 01
    jmp("increment")     # 00 -> 10
    jmp("update")        # 00 -> 11
    jmp("increment")     # 01 -> 00
    jmp("update")        # 01 -> 01
    jmp("update")        # 01 -> 10
    jmp("decrement")     # 01 -> 11
    jmp("decrement")     # 10 -> 00
    jmp("update")        # 10 -> 01
    jmp("update")        # 10 -> 10
    jmp("increment")     # 10 -> 11
    jmp("update")        # 11 -> 00
    jmp("increment")     # 11 -> 01
    label("decrement")
    jmp(y_dec, "update")  # 11 -> 10: solo decrementa Y
    wrap_target()
    label("update")
    mov(isr, y)          # 11 -> 11
    push(noblock)
    out(isr, 2)          # estado anterior (guardado en OSR) al ISR
    in_(pins, 2)         # estado actual de A y B
    mov(osr, isr)        # guarda los 4 bits para la siguiente vuelta
    mov(pc, isr)         # salto calculado a la tabla
    label("increment")
    mov(y, invert(y))
    jmp(y_dec, "increment_cont")
    label("increment_cont")
    mov(y, invert(y))
    wrap()
    # Relleno a 32 instrucciones para que el programa quede en la dirección 0
    nop()
    nop()
    nop()
    nop()
    nop()
    nop()
    nop()
    nop()


class EncoderPIO:
    def __init__(self, sm_id, pin_a):
        # B tiene que ser el GPIO siguiente a A
        Pin(pin_a, Pin.IN, Pin.PULL_UP)
        Pin(pin_a + 1, Pin.IN, Pin.PULL_UP)
        self.sm = rp2.StateMachine(sm_id, quadrature_encoder, in_base=Pin(pin_a))
        self.sm.active(1)

    def count(self):
        # Vacía el FIFO y espera un dato nuevo, igual que quadrature_encoder_get_count()
        n = self.sm.rx_fifo() + 1
        while n:
            v = self.sm.get()
            n -= 1
        return v - (1 << 32) if v & 0x80000000 else v  # a entero con signo
Si no le pasas freq, la máquina de estados corre a la frecuencia del sistema. Las máquinas 0 a 3 son del PIO 0 y la 4 a 7 del PIO 1; como el relleno ocupa toda la memoria de un bloque, los cuatro encoders de ese bloque tienen que usar este mismo programa, y MicroPython reutiliza la copia ya cargada. Para medir velocidad:
import time
from encoder_pio import EncoderPIO

CPR = 4 * 600
enc = EncoderPIO(0, 10)  # máquina 0, A en GP10, B en GP11

n0, t0 = enc.count(), time.ticks_us()
while True:
    time.sleep_ms(100)
    n, t = enc.count(), time.ticks_us()
    delta = ((n - n0 + (1 << 31)) % (1 << 32)) - (1 << 31)  # tolera la vuelta del contador
    dt = time.ticks_diff(t, t0) / 1_000_000
    print(n, delta / CPR / dt * 60, "rpm")
    n0, t0 = n, t
Calcular la velocidad y su resolución
Con dos lecturas separadas por , la velocidad es
La resolución es una cuenta por ventana. Con 2400 CPR y ms, una cuenta equivale a rpm. A 3000 rpm eso es menos del 0.1 %, pero a 20 rpm la lectura salta entre valores separados por 2.5 rpm. Alargar la ventana mejora la resolución a cambio de retraso en el lazo de control. Para velocidades bajas, pico-examples incluye quadrature_encoder_substep, que además del conteo mide cuánto tiempo pasó desde la última transición y combina las dos cosas.
El contador es un entero de 32 bits que da la vuelta. Con 2400 CPR, llegar de 0 a requiere vueltas, pero si tu sistema corre mucho tiempo en un solo sentido, calcula las diferencias como en los ejemplos y no compares cuentas absolutas.
Hasta qué frecuencia cuenta bien
Como el peor camino del programa tarda 10 ciclos, el límite es
A 125 MHz, la frecuencia por defecto del SDK para el RP2040, son 12.5 millones de transiciones por segundo. A 150 MHz, la del RP2350, son 15 millones. Lo comprobamos con un emulador de PIO: con transiciones cada 10 ciclos o más la cuenta coincidió con la posición real después de 3533 pasos con cambios de sentido, y con 9 ciclos ya perdía pasos.
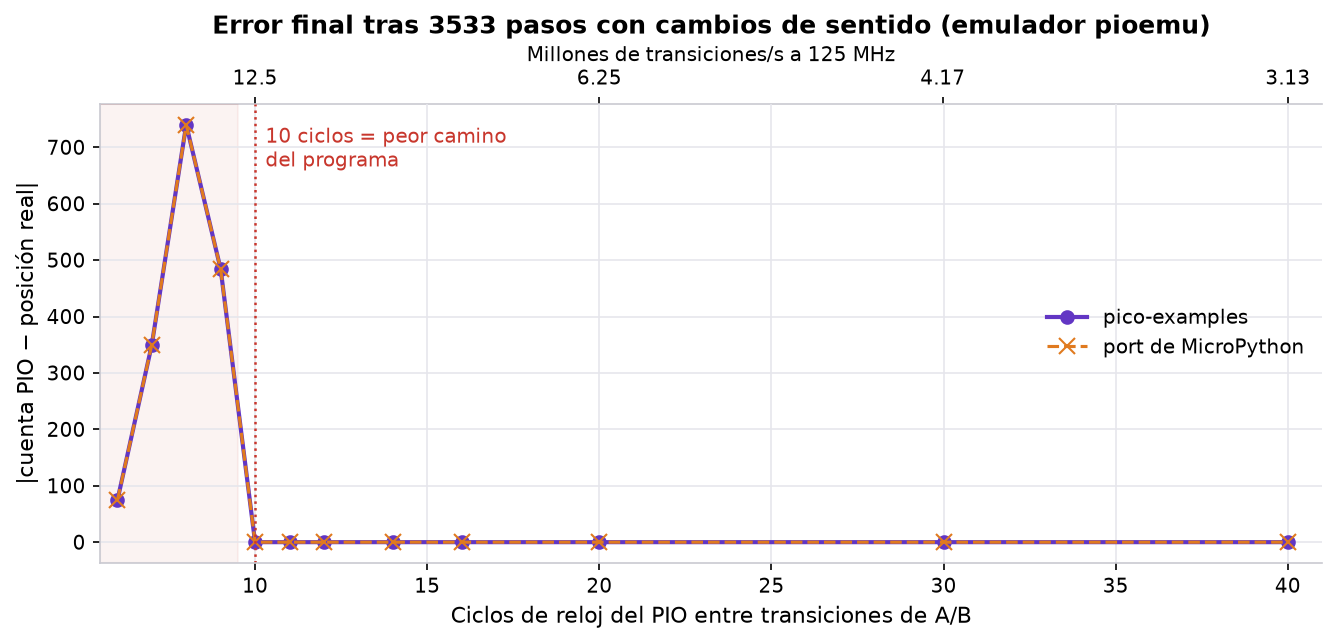
Por debajo de 10 ciclos el error no sigue ningún patrón: con 8 ciclos la cuenta terminó 740 pasos fuera y con 6 solo 74, por simple casualidad en el orden de los estados que se perdieron. Lo único confiable es el umbral. Los dos programas, el oficial y el port de MicroPython, dieron exactamente los mismos números.
Para el eje, ese límite casi nunca es el problema. Con el encoder de 600 PPR del ejemplo:
Ese límite se refiere al tiempo entre dos transiciones cualesquiera de A o B, no a la frecuencia de A. Si el encoder tiene el desfase lejos de 90° o los ciclos de trabajo desiguales, algunos flancos quedan más juntos que el promedio. Con ciclo de trabajo del 50 % y un desfase de , la separación mínima entre flancos dentro de un periodo de la señal A es
Con la separación mínima es en lugar de , y ese intervalo, no el promedio, es el que tiene que durar al menos 10 ciclos. En la práctica el límite lo ponen antes la calidad de la señal y el cableado: los pull-ups internos son débiles, el PIO no filtra glitches y cualquier pulso de ruido se cuenta. Con cables largos usa pull-ups externos, un filtro RC dimensionado para tu frecuencia máxima o un encoder diferencial con su receptor de línea.
Si no necesitas tanta velocidad, el parámetro max_step_rate de quadrature_encoder_program_init() baja el reloj del PIO a y ahorra energía.
Cómo lo probamos
No usamos hardware para este artículo. Ensamblamos el .pio oficial con adafruit_pioasm y el port de MicroPython con el ensamblador de rp2.py de MicroPython ejecutado en CPython; las primeras 24 instrucciones salen idénticas y las 8 restantes son el relleno. Después corrimos los dos programas en el emulador pioemu con el OSR corriendo a la derecha y el wrap entre las direcciones 15 y 23, alimentando señales A/B sintéticas con distintos periodos. El código en C sigue al ejemplo oficial pero no lo compilamos aquí.
Del encoder al lazo de control
Máquina de estados de cuadratura
Referencias
- pico-examples,
quadrature_encoder.pio: https://github.com/raspberrypi/pico-examples/blob/master/pio/quadrature_encoder/quadrature_encoder.pio - pico-examples,
quadrature_encoder.c: https://github.com/raspberrypi/pico-examples/blob/master/pio/quadrature_encoder/quadrature_encoder.c - pico-examples,
quadrature_encoder_substep: https://github.com/raspberrypi/pico-examples/tree/master/pio/quadrature_encoder_substep - pico-sdk 2.1.1, notas de versión (125 MHz y 150 MHz por defecto): https://github.com/raspberrypi/pico-sdk/releases/tag/2.1.1
- pico-sdk,
hardware/pio.h(dos bloques PIO en RP2040, tres en RP2350): https://github.com/raspberrypi/pico-sdk/blob/master/src/rp2_common/hardware_pio/include/hardware/pio.h - MicroPython,
rp2.StateMachine: https://docs.micropython.org/en/latest/library/rp2.StateMachine.html - MicroPython,
rp2yasm_pio: https://docs.micropython.org/en/latest/library/rp2.html - MicroPython,
machine.Pin.irq: https://docs.micropython.org/en/latest/library/machine.Pin.html - Pololu 3pi+ 2040,
pio_quadrature_counter.py: https://github.com/pololu/pololu-3pi-2040-robot/blob/master/micropython_demo/pololu_3pi_2040_robot/_lib/pio_quadrature_counter.py - Raspberry Pi forums, orden de carga de programas PIO: https://forums.raspberrypi.com/viewtopic.php?t=360306
- rp2040-pio-emulator (pioemu): https://github.com/NathanY3G/rp2040-pio-emulator